La inteligencia artificial coloca los derechos de autor en el centro del debate del VI Encuentro Regional ACTE Canarias
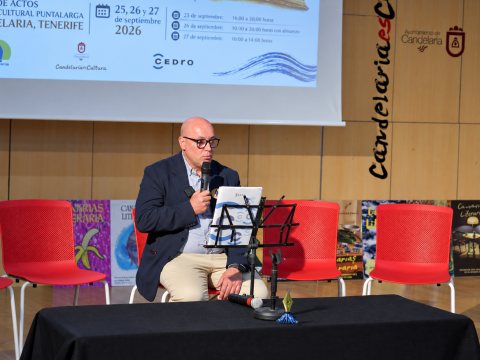
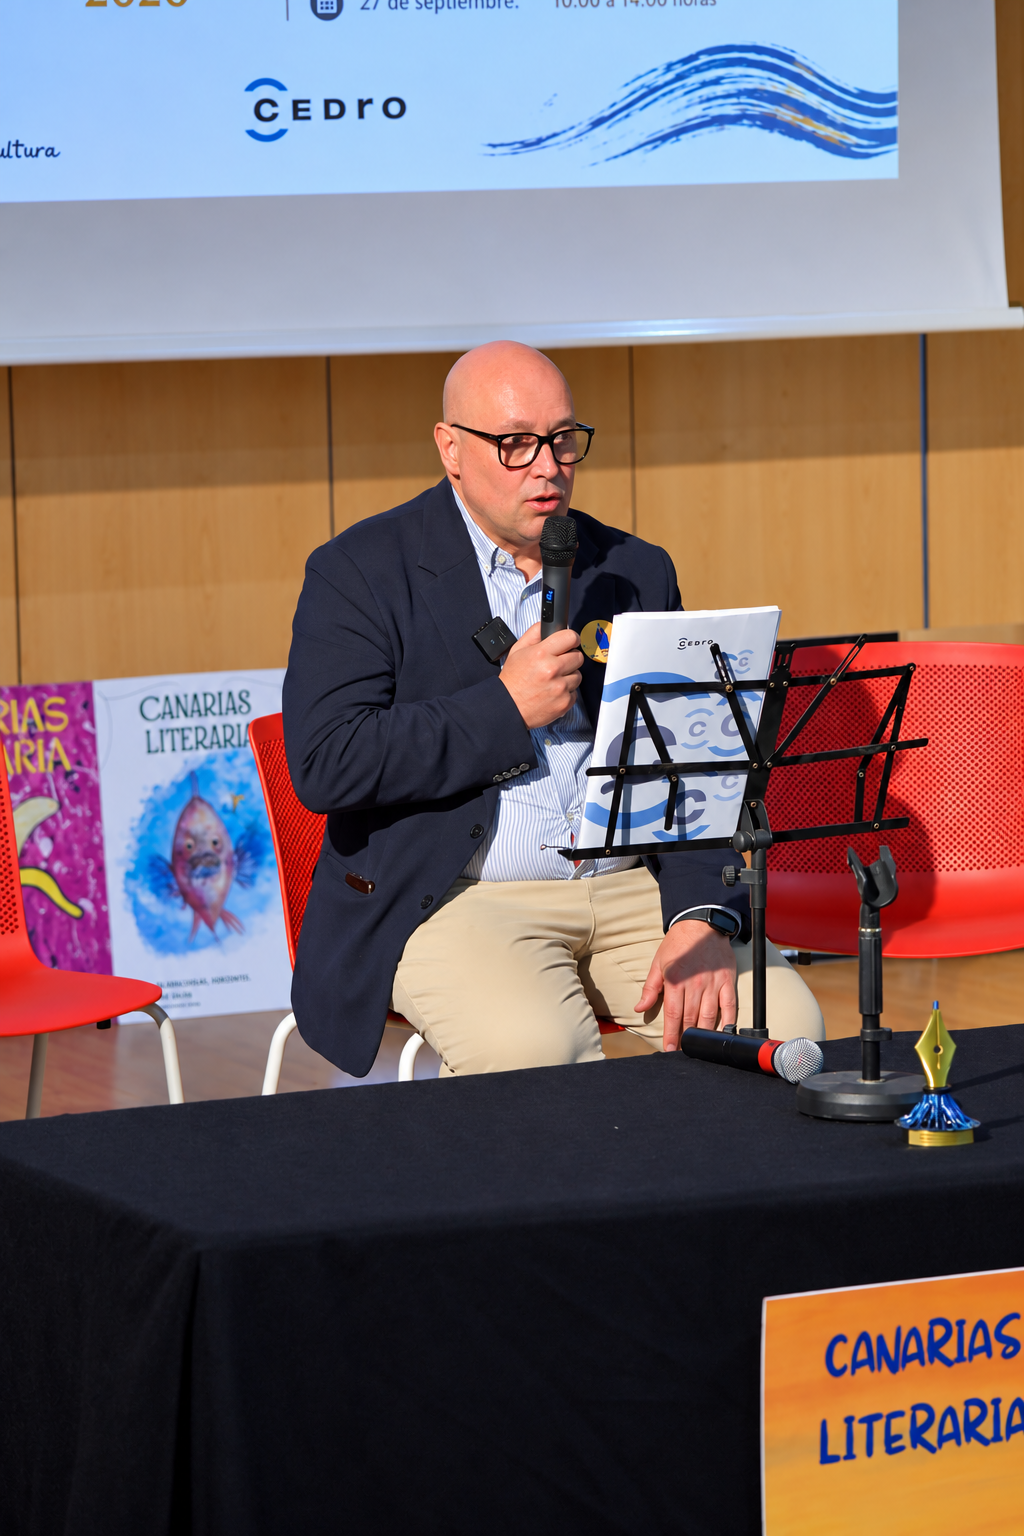
Pedro Sánchez, director de Socios de CEDRO, analizó el pasado 25 de septiembre los retos que plantea el entrenamiento de modelos de inteligencia artificial (IA) con obras protegidas por el derecho de autor y defendió tres principios fundamentales para desarrollar estos sistemas de forma responsable con la autoría: autorización, remuneración y transparencia.
La irrupción de la IA generativa ha cambiado en muy poco tiempo numerosas formas de trabajar, comunicar, investigar y crear. Pero detrás del vertiginoso avance tecnológico permanece abierta una cuestión fundamental: ¿qué sucede con las obras utilizadas para entrenar esos sistemas y con los derechos de las personas que las crearon?
Esa pregunta centró la intervención de Pedro Sánchez durante el VI Encuentro Regional ACTE Canarias 2026, celebrado el 25 de septiembre, en una charla titulada La IA, los derechos de autor y el papel de la entidad en su protección.
Ante escritores y creadores, Sánchez dibujó un escenario especialmente complejo para la propiedad intelectual. Uno de los principales asuntos abordados fue la utilización de grandes cantidades de libros, artículos de prensa, publicaciones y otros materiales protegidos para entrenar herramientas de IA sin que necesariamente haya existido una autorización previa de sus autores.
Durante su exposición describió esta situación como un “gran expolio de la propiedad intelectual”, una expresión que sintetizó la preocupación existente en buena parte del sector creativo ante los modelos empresariales construidos, en parte, sobre grandes conjuntos de datos que incluyen contenidos editoriales protegidos.
El debate ya ha llegado a los tribunales en diferentes países. Uno de los ejemplos mencionados fue el litigio contra Anthropic en Estados Unidos. Tal y como se ha explicado en medios, autores como Andrea Bartz, Charles Graeber y Kirk Wallace Johnson demandaron a la compañía alegando que sus libros habían sido utilizados sin autorización para entrenar sus modelos de IA. Anthropic sostuvo que ese entrenamiento constituía un uso transformador amparado por el principio estadounidense de fair use. El procedimiento terminó en 2025 con un acuerdo entre la compañía y los autores demandantes.
La situación demuestra que todavía no existe una respuesta uniforme a escala mundial. Legisladores, tribunales, entidades de gestión, empresas tecnológicas y organizaciones de creadores continúan discutiendo los límites jurídicos del entrenamiento de modelos de IA y el alcance de las excepciones previstas en las diferentes legislaciones.
Frente al conflicto, la charla puso también sobre la mesa experiencias que buscan fórmulas de colaboración entre tecnología y titulares de derechos.
Uno de los ejemplos destacados de buenas prácticas fue Noruega. Allí, la Biblioteca Nacional noruega y Kopinor, organización de gestión colectiva que representa a autores y editores, han alcanzado acuerdos que permiten utilizar determinados contenidos protegidos para el desarrollo de modelos lingüísticos noruegos y sami, incorporando mecanismos de licencia y remuneración económica para los titulares de los derechos. Kopinor explica que estos acuerdos pretenden compatibilizar el desarrollo tecnológico con la protección de los intereses económicos y morales de autores y editores.
Para CEDRO, el camino pasa por tres conceptos que Pedro Sánchez reiteró durante su intervención: autorización, remuneración y transparencia.
Autorización para que los creadores puedan decidir sobre determinados usos de sus obras. Remuneración para que quienes generan los contenidos que alimentan esos sistemas participen del valor económico generado. Y transparencia para conocer qué materiales han sido utilizados y bajo qué condiciones.
La Unión Europea ha comenzado a introducir obligaciones específicas en esta materia a través del Reglamento de Inteligencia Artificial. Desde el 2 de agosto de 2025, los proveedores de modelos de inteligencia artificial de uso general deben, entre otras obligaciones, establecer políticas destinadas a cumplir la legislación europea sobre derechos de autor y publicar un resumen suficientemente detallado de los contenidos utilizados en el entrenamiento de sus modelos.
Durante la charla se manifestó, sin embargo, que desde la perspectiva de CEDRO y de parte del sector creativo, estas obligaciones todavía resultan insuficientes para garantizar una protección efectiva de los autores.
Pero la intervención no se limitó al terreno jurídico.
Pedro Sánchez planteó también las consecuencias medioambientales y sociales derivadas del desarrollo masivo de la inteligencia artificial. La expansión de centros de datos y de grandes infraestructuras tecnológicas abre interrogantes sobre el consumo de agua y energía, la extracción de minerales y tierras raras necesarios para determinados componentes tecnológicos y el impacto global de una industria cuyo crecimiento se está produciendo a enorme velocidad.
Junto a ello aparece otra realidad menos visible: el trabajo humano que continúa existiendo detrás de muchos sistemas de inteligencia artificial. Tareas de clasificación, moderación, etiquetado o preparación de datos pueden desarrollarse en contextos laborales muy distintos y han generado debates internacionales sobre las condiciones y remuneraciones de determinados trabajadores vinculados a estas cadenas productivas.
La cuestión, por tanto, no consiste simplemente en decidir si inteligencia artificial sí o inteligencia artificial no.
El verdadero debate pasa por determinar qué modelo de inteligencia artificial queremos construir.
Una tecnología capaz de convertirse en herramienta para escritores, músicos, periodistas, ilustradores, investigadores y creadores, pero que al mismo tiempo respete el trabajo previo sobre el que se desarrolla.
La intervención de Pedro Sánchez terminó situando la mirada precisamente en ese punto: buscar soluciones que permitan aprovechar las posibilidades de la inteligencia artificial sin poner en peligro el sostenimiento económico y cultural de quienes crean.
Porque la creación no es únicamente el resultado final que aparece en una pantalla o en las páginas de un libro. Detrás existen años de formación, investigación, experiencia, tiempo y trabajo.
Y si la tecnología del futuro necesita de la creación humana para aprender, uno de los grandes desafíos de nuestro tiempo será conseguir que también contribuya a sostener a quienes hacen posible esa creación